Gjør dokumenter søkbare med OCR
Finn informasjon raskt i alle skannede dokumenter.
Hva er OCR (tekstgjenkjenning)?
OCR (Optical Character Recognitioan), også kjent som tekstgjenkjenning, konverterer bilde til tekst, slik at skannede dokumenter kan bli søkbar digital tekst.
Et skannet dokument er egentlig et "digitalt foto" av alle sidene. Mennesker kan enkelt lese og forstå teksten ved å se på bildet, men en datamaskin kan ikke gjøre mye ut av det.
For å kunne gjøre bruk av selve teksten må dokumentet kjøres gjennom en OCR-prosess, som analyserer og tolker skannede bilder og konverterer dem til ekte elektronisk tekst.
Hvorfor trenger du OCR?
OCR øker verdien av de skannede dokumentene ved at innholdet blir søkbart og gjenbrukbart.
Noen eksempler på hvor dette gjør en reell forskjell:
Søkbar PDF med OCR
OCR er viktig ved skanning av papirdokumenter til PDF, fordi det gjør PDF-filene søkbare. Filene kan indekseres i dokumenthåndteringssystemet og raskt hentes frem fra arkivet senere.
PixEdit applikasjonene lagrer både den elektroniske teksten og det skannede bildet i PDF-filen, såkalt "skjult" tekst. Dokumentene blir fullt søkbare og teksten kan gjenbrukes, samtidig som den visuelle fremstillingen er identisk med originalen (i henhold til Riksarkivets retningslinjer for arkivering).
OCR med PixEdit Office
Tekstgjenkjenning er innebygd i PixEdit Office, i ulike språk. Programvaren gjenkjenner automatisk om et dokument allerede inneholder tekst, slik at bare de sidene som trenger det blir behandlet.
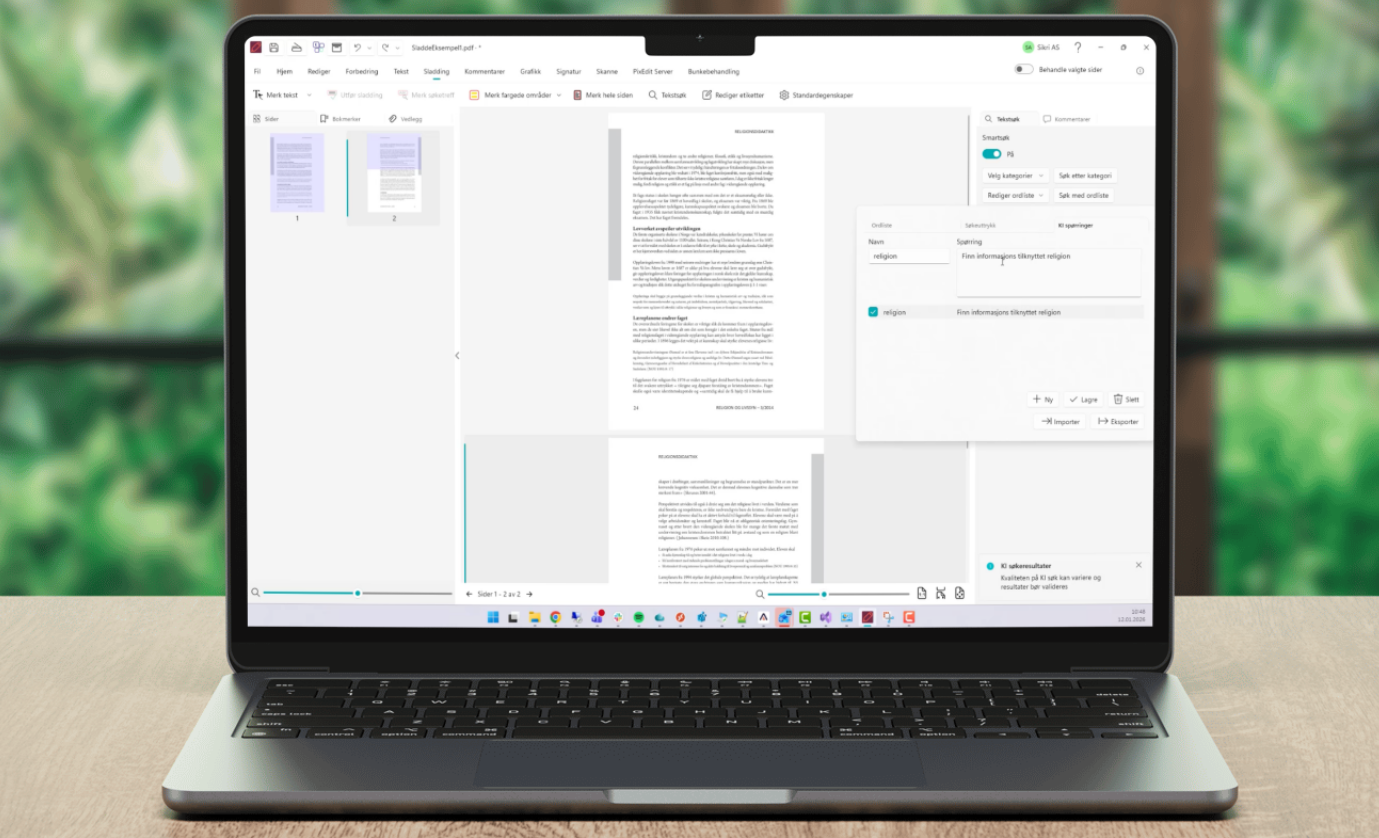
Ønsker du i tillegg avansert søk i den gjenkjente teksten finnes dette som smartsøk i PixEdit Office Professional.
-1.png?width=1379&height=838&name=PixEdit%20grafikk%20(5)-1.png)
Se hvordan OCR fungerer i praksis
Vi viser deg hvordan PixEdit Office sparer deg for timevis av leting ved å gjøre dine skannede sokumenter søkbare.